Du willst KI in deiner Fertigungsstraße nutzen, weißt aber nicht, womit du realistisch startest? Hier bekommst du eine kurze Orientierung mit klaren Kriterien, damit du schnell zu einem tragfähigen Pilot kommst – ohne Großprojekt-Falle.
Kurzübersicht
- Starte mit einem eng umrissenen Use-Case (z. B. optische Qualitätsprüfung), der messbar Ausschuss oder Nacharbeit reduziert.
- Setze auf vorhandene Maschinendaten via OPC-UA; fehlende Signale ergänzt du gezielt mit Sensorik statt Komplettumbau.
- Wähle eine Architektur, die Edge-Auswertung für Latenz und eine Cloud für Training/Versionierung kombiniert.
- Plane Integration über klare APIs in MES/ERP – erst Read-only, dann schrittweise Automatisierungsbefehle.
- Definiere vorab Erfolgsmetriken (z. B. False-Reject-Rate, Stillstandszeit) und einen maximalen Pilotumfang von 8–12 Wochen.
Warum ein pragmatischer Start bei KI-Projekten in der Produktion zwingend ist
Am Anfang entscheidet Fokus über Tempo: Ein MVP mit klaren Metriken minimiert Produktionsrisiken und schafft belastbare Learnings für Skalierung – von Bildverarbeitung über Anomalieerkennung bis Predictive Maintenance. Für breitere Markt- und Branchenkontexte lohnt sich ein Blick auf https://www.wirtschaft-und-industrie.de. Wenn du parallel digitale Prioritäten im Unternehmen sortierst, hilft dir dieser Überblick als Einordnung: Citations für den Mittelstand: Wann KMU aktiv werden sollten.
Welche KI-Aufgaben passen zu deiner Fertigungsstraße?
Nicht jeder Anwendungsfall zahlt sofort auf Verfügbarkeit oder Qualität ein. Starte dort, wo Signale klar messbar und Daten halbwegs strukturiert sind. Drei Einstiegskandidaten haben sich bewährt: optische Qualitätsprüfung (Bildverarbeitung), Anomalieerkennung auf Maschinendaten und vorausschauende Wartung. Sie unterscheiden sich in Datenquellen, Latenzanforderungen und Einführungsaufwand – und damit in der Eignung für einen schnellen Pilot ohne Linienstillstand.
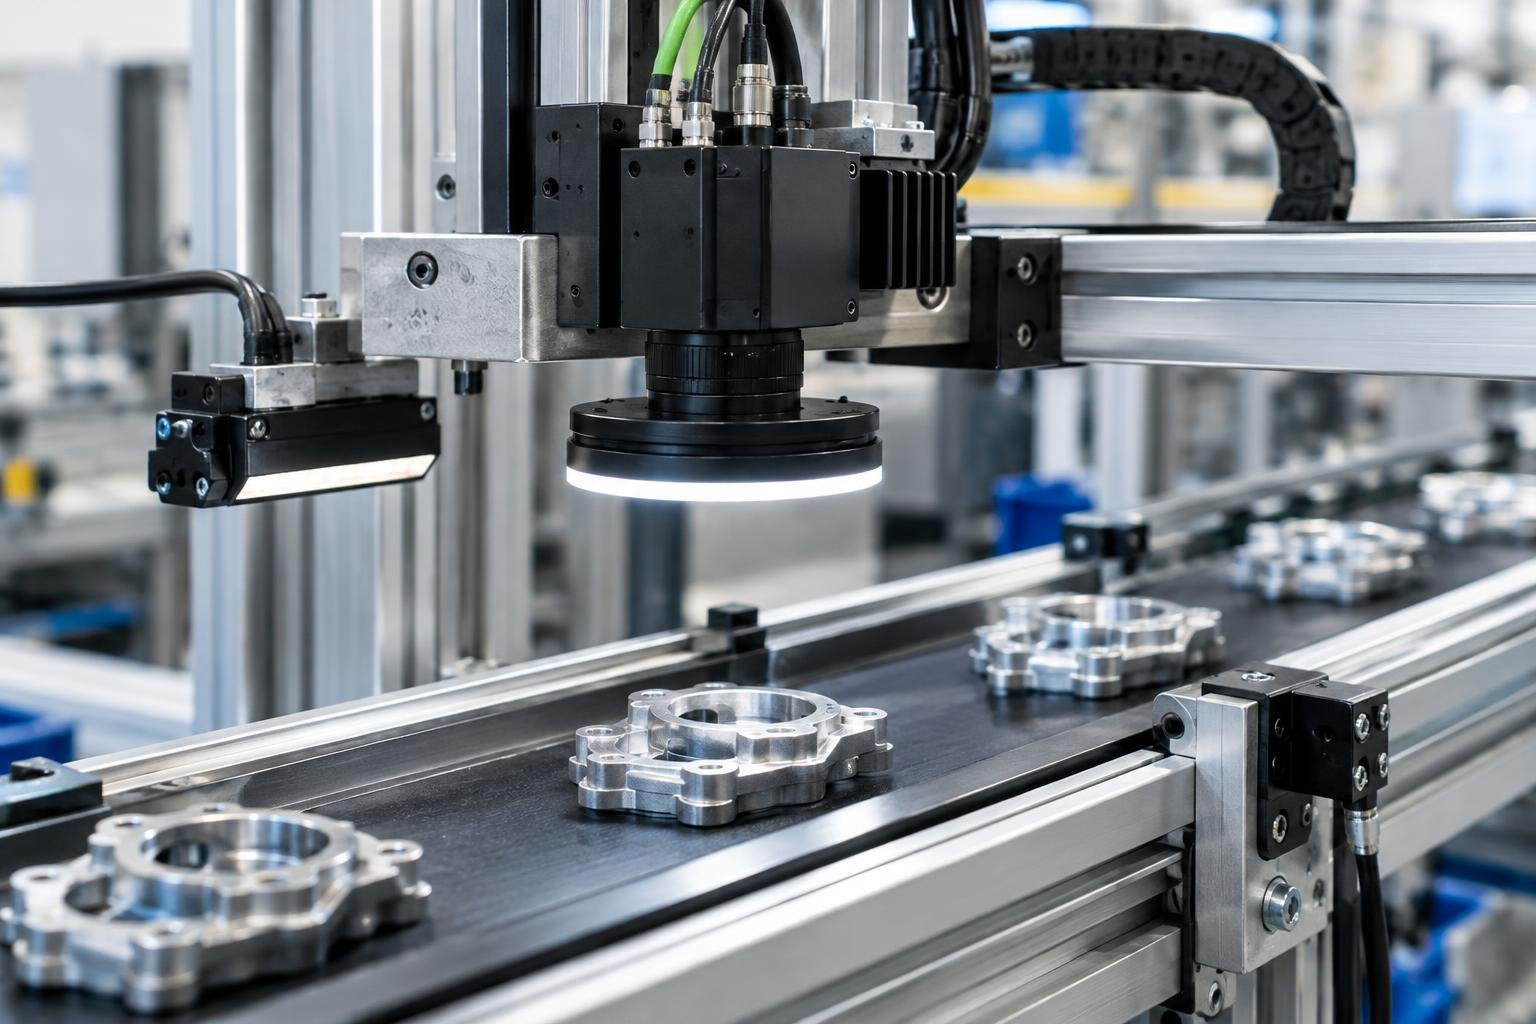
- Bildverarbeitung (Computer Vision): Geeignet, wenn visuelle Defekte oder Fehlmontagen häufig sind. Erfordert stabile Beleuchtung, Kameras an kritischen Stationen und ein kleines Set gelabelter Bilder zum Start (wird iterativ erweitert).
- Anomalieerkennung: Nutzt vorhandene Maschinendaten (z. B. Vibrations-, Strom-, Temperaturkurven über OPC-UA). Gut für „Frühwarnung“ bei Drift oder Fehlbedienung, oft mit rein unlabeled Daten startbar.
- Predictive Maintenance: Baut auf Historien mit Störungs- oder Wartungsereignissen auf. Liefert Mehrwert, wenn Ausfälle teuer oder sicherheitskritisch sind und Sensordaten über Zyklen hinweg konsistent vorliegen.
Nutzen vs. Aufwand: So priorisierst du den ersten Pilot
Für schnelle Ergebnisse zielt die Priorisierung auf hohes Fehlerrisiko + überschaubare Integration. Ein Beispiel: Eine Kamera an der End-of-Line-Prüfung ist oft schneller eingebunden als tief in einer verketteten Station. Um die Einordnung greifbar zu machen, kannst du eine einfache Matrix (Nutzenpotenzial, Datenreife, Integrationsaufwand) skizzieren und die Top-2 Kandidaten in einem MVP gegeneinander testen.
| Use-Case | Typische Daten | Implementierungsaufwand | Sinnvoller Pilotumfang |
|---|---|---|---|
| Bildverarbeitung | Kamerabilder, wenige hundert gelabelte Beispiele | Mittel (Kamera/Beleuchtung, Edge-Inferenz) | 1 Station, 1–2 Merkmalsklassen, Shadow-Mode → Live |
| Anomalieerkennung | OPC-UA-Signale, Zeitenreihen (Vibration, Strom) | Niedrig–mittel (Datenanbindung, Basismodell) | 1 Maschine, 2–4 Wochen Daten, Alarme im Dashboard |
| Predictive Maintenance | Zeitenreihen + Störungs-/Wartungshistorie | Mittel–hoch (Labelqualität, Validierung) | 1 kritisches Aggregat, Health-Score, Probefallprüfung |
| Robotik-Koordination | Sensordaten, Takt-/Positionsinformationen | Hoch (Echtzeit, Sicherheitsabnahmen) | Abgegrenzte Zelle, Simulationslauf → begrenzte Live-Phase |
Was du vorab klärst – ohne in Detailplanung zu versinken
Lege fest, welche Station messbar profitieren soll (z. B. -20% Ausschuss, -15% Stillstandsminuten) und wie du Effekte isolierst. Prüfe außerdem kurz, ob ein Shadow-Mode möglich ist, um Risiken zu minimieren. Für Kontext jenseits der eigenen Linie kann ein Blick auf https://www.wirtschaft-und-industrie.de helfen, Markt- und Branchenimpulse einzuordnen.
Wenn du abschätzen willst, welche externen Informationen über dein Unternehmen in Modelle einfließen könnten, ist dieser Überblick nützlich: So prüfst du, was KI über dein Unternehmen weiß. Das hilft beim Erwartungsmanagement für Datenfreigaben und interne Compliance.
So setzt du ein KI‑Pilotprojekt in der Produktion um
Bevor du an Modelle denkst, klärst du drei Basics: (1) konkretes Ziel mit Kennzahl, (2) sauberer Datenzugang, (3) definierter Eingriffspunkt in der Linie. Danach arbeitest du in kurzen Sprints, jeweils mit messbarem Zwischenstand.
- Use‑Case und KPI festnageln: Formuliere ein MVP: z. B. „Fehlerklasse X in Station Y erkennen; False‑Rejects < 3%“. Lege Messzeitraum und Abnahmeformat fest (Report, Dashboard, Alarm).
- Datenzugang sichern: Für Maschinendaten nutze OPC‑UA/JSON‑Streams; für Bildverarbeitung definierst du Auflösung, Bildrate, Beleuchtung und Trigger. Vereinbare ein fixes Schema (Zeitstempel, Produkt-ID, Label).
- Edge zuerst, Cloud später: Inference nahe der Maschine (Edge Computing) reduziert Latenz; Training und Monitoring können in die Cloud wandern, wenn Bandbreite und Compliance passen.
- Labeling & Datenqualität: Starte mit 300–800 repräsentativen Beispielen pro Fehlerklasse oder Zeitraum. Dokumentiere Ablehnungsgründe und Sensorzustände, um Drift sichtbar zu machen.
- Integrationspfad definieren: Wie fließt das Ergebnis in die Steuerung? Beginne mit „Assist Mode“ (Hinweis an Werker), dann schalte auf „Auto Stop/Auto Sort“, sobald die KPI stabil sind.
- Iterativ testen: Führe einen Linien‑A/B‑Vergleich durch (KI an/aus) über mehrere Schichten, gleiche Produktvarianten.
Tipp: Blocke 90 Minuten für ein Shopfloor‑Gemba: Geh die Linie ab und notiere je Station Ziel‑KPI, verfügbare Signale, Eingriffsmöglichkeit und Verantwortliche – das wird deine schnelle Pilot‑Map.
Kompakte Auswahlhilfe für deinen Erst‑Use‑Case
| Use‑Case | Datenanforderung | Implementierungsaufwand | Sinnvoller Pilotumfang |
|---|---|---|---|
| Bildverarbeitung (Qualitätsprüfung) | Kamera, konstantes Licht, Trigger; 8–12 Bit Graustufen/Farbe | Mittel (Optik/Beleuchtung + Modell) | 1 Station, 1–2 Fehlerklassen, 1 Produktvariante |
| Anomalieerkennung (Prozess) | OPC‑UA‑Signale, Zeiten, Ströme, Vibration | Niedrig bis mittel (Feature‑Engine, Schwellen) | 1 Maschine, 1 Zyklusart, Schichtvergleich |
| Predictive Maintenance | Vibration/Temperatur + Historie von Ausfällen | Mittel (Sensorik + Historik) | 1 Aggregat, 1 Verschleißteil, klarer Alarmkanal |
| Robotik‑Koordination | Positionsdaten, Taktzeiten, Safety‑Zonen | Höher (Schnittstellen + Safety) | 1 Roboterzelle, 1 Teilprozess, definierte Puffer |
Plane die Architektur schlicht: Sensorik/Kameras –> Edge‑Gateway (Vorverarbeitung, Modelle) –> API zur Leitsteuerung/MES. Halte Eingriffe idempotent: ein KI‑Signal triggert stets denselben, nachvollziehbaren Aktor oder Hinweis.
Wenn du Text‑/Wissenszugriff brauchst (z. B. Handbuchabfragen für Störungen), prüfe RAG‑basierte Module für Schichtanleitungen und Fehlersuche – Hintergründe zu RAG findest du in unserem kompakten Einstieg: Was ist RAG?
Mini‑Checkliste für die Pilot‑Entscheidung
- Use‑Case: Welches Problem, welche KPI, welches Abnahmefenster?
- Datenverfügbarkeit: Sensoren/Kameras vorhanden, Zugriffsrechte geklärt?
- Integrationsaufwand: Wo erscheint das Ergebnis (HMI, Andon, SPS)?
- Pilotumfang: Eine Linie/ein Maschinentyp, Laufzeit 4–8 Wochen?
- Risiko & Safety: Fail‑Safe bei Modellfehlern definiert?
- Betreiberfit: Wer bedient, wer wartet, wer labelt?
- Skalierbarkeit: Wiederholbare Edge‑/Cloud‑Bausteine?
- ROI‑Pfad: Wie werden Einsparungen gemessen und freigegeben?
Häufiger Fehler: Zu großes Projektziel beim ersten Schritt: Unternehmen planen sofort eine vollständige Linienautomatisierung statt eines eng begrenzten Pilots.
So lässt sich der Fehler vermeiden: Definiere ein enges MVP mit klaren Erfolgskriterien (z. B. Fehlerklasse X erkennen, Downtime um Y Prozent reduzieren) und begrenze Umfang auf eine Linie oder einen Maschinentyp; nutze die Entscheidungs‑Checkliste zur Abgrenzung.
Sorge zum Schluss für einen klaren „Go/No‑Go“-Meilenstein: Wenn die KPI das Ziel in zwei aufeinanderfolgenden Wochen erreicht, hebst du in den Automatikmodus und planst die nächste Station. Sonst justierst du Daten, Beleuchtung oder Schnittstellen – nicht das Ziel.
Häufige Fragen — kurz beantwortet
Wie lange dauert ein realistisch geschnittener KI‑Pilot?
Für einen eng umrissenen Use‑Case (z. B. optische Qualitätsprüfung an einer Station) solltest du 8–12 Wochen kalkulieren: 2 Wochen Datenzugang/IT‑Freigaben, 3–4 Wochen Datenaufbereitung und Baseline, 2–3 Wochen Modell/Regeln, 1–3 Wochen Shopfloor‑Test.
Welche Datenmenge brauche ich für einen Start?
Richtwerte: Bildverarbeitung 3–10k gelabelte Bilder pro Fehlerklasse (Start auch mit weniger via aktives Lernen), Anomalieerkennung 2–4 Wochen kontinuierliche Maschinendaten (OPC‑UA) im Normalbetrieb, Predictive Maintenance mehrere Zyklen bis zum Ausfallereignis, notfalls mit Proxy‑Labels (Temperatur‑Drift, Vibration).
Müssen alle Daten in die Cloud?
Nein. Latenz‑kritische Inferenz (z. B. Ausschleusen) läuft am Edge, Training/Monitoring kann in der Cloud stattfinden. Trenne klar: Edge für Realtime, Cloud für Skalierung und Auswertung. Achte auf saubere Schnittstellen (API) und einheitliche Schemas.
Wie binde ich KI ohne SPS‑Umbau ein?
Über einen nicht‑invasiven Nebenpfad: Sensor/Kamera erfasst, Edge‑Rechner bewertet, Ergebnis geht per MQTT/REST an ein Gateway, das ein digitales Signal (OK/NOK) an die SPS liefert. So bleibt die Sicherheitslogik unangetastet.
Was kostet der Betrieb (grob)?
Edge‑Hardware im unteren vierstelligen Bereich pro Station, plus Engineering für Integration und Labeling. Laufende Kosten entstehen vor allem durch Datenhaltung, Retraining und Wartung der Pipelines. Plane ein kleines, fixes OPEX‑Budget pro Linie.
Wie bewerte ich den ROI vorab?
Nutze eine einfache Nutzenformel: vermiedener Ausschuss/Nacharbeit + vermiedene Stillstandminuten − Zusatzaufwand (Labeling, Hardware, Integration). Lege die KPI‑Schwelle fest, ab der der Pilot skaliert wird.
Was, wenn die Datenqualität schwankt?
Baue Datenmonitoring ab Tag 1 ein (Drift, Ausfall von Sensoren, Bildbeleuchtung). Definiere Fallbacks: bei Unsicherheit -> manueller Prüfschritt statt automatischer Entscheidung.
Wie beginne ich konkret nächste Woche?
- Wähle einen Use‑Case mit klarem Eingriffspunkt und KPI.
- Klär den Datenzugriff (OPC‑UA/CSV/Kamera) und Rechtsrahmen.
- Stelle ein Kernteam auf (OT, IT, Fachbereich) und timeboxe 10 Wochen.
- Plane ein Review nach Woche 4 mit Go/No‑Go.
Kurz noch ein Hinweis abseits der Technik: Wenn du Begrifflichkeiten sauber halten willst, hilft dieser Überblick zu Citations als Referenz im Webumfeld – nützlich, um Projektdokumentation und externe Quellen konsistent zu benennen.